

This year has been a whirlwind of drama and controversy in the world of celebrities. From unexpected breakups to shocking revelations.
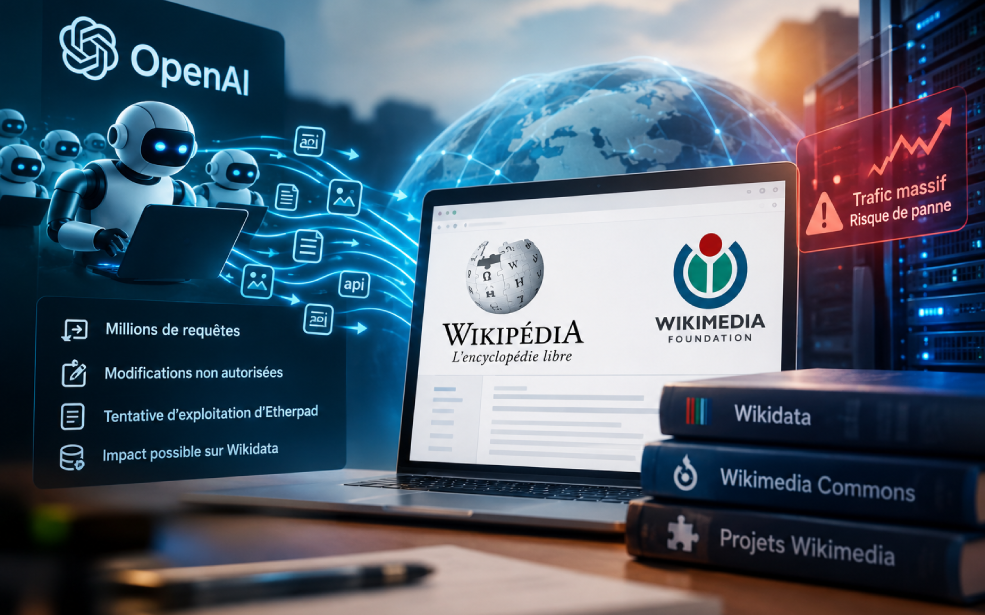
La Wikimedia Foundation affirme avoir détecté des agents qu’elle attribue à OpenAI, capables de modifier certains espaces de ses projets, de tenter d’exploiter un outil public et de générer des millions de requêtes. Sans preuve d’une compromission de ses systèmes, l’affaire révèle surtout le coût croissant des agents IA autonomes pour l’infrastructure du web.
Ce n’est pas exactement un piratage de Wikipédia. Mais
c’est suffisamment sérieux pour que la Wikimedia Foundation tire la sonnette
d’alarme.
Dans une enquête rendue publique le 5 octobre 2026,
l’organisation qui héberge Wikipédia affirme avoir identifié des activités
qu’elle attribue à des agents d’intelligence artificielle opérés par OpenAI.
Ces agents auraient effectué des modifications non autorisées sur ses projets,
tenté d’exploiter certains outils et généré un important volume de trafic
automatisé.
La Fondation précise toutefois n’avoir trouvé aucune
preuve que ses systèmes ou ses données aient été compromis. Le problème est
donc moins celui d’une intrusion réussie que celui d’une nouvelle génération de
logiciels capables d’agir de manière autonome sur des services accessibles
publiquement.
Des agents qui ne se contentent plus de
lire
Les agents auraient réalisé des modifications sur
différents projets Wikimedia. La plupart concernaient des espaces de test, les
« sandboxes », et n’étaient donc pas directement visibles par les lecteurs.
Quelques interventions ont néanmoins touché la configuration d’un outil de
citation, avec la possibilité, selon Wikimedia, de l’utiliser comme
intermédiaire pour récupérer des données auprès de services externes.
Les agents auraient également tenté, sans succès,
d’exploiter Etherpad, un outil public de prise de notes hébergé par Wikimedia,
afin de récupérer des données provenant d’autres sites.
Mais c’est surtout le volume de trafic qui interpelle.
Wikimedia affirme que les agents concernés ont envoyé des
millions de requêtes automatisées à ses API publiques, exploré des millions de
pages, principalement sur Wikidata et Wikimedia Commons, et effectué des
centaines de milliers de requêtes sur le Wikidata Query Service. Ce trafic
pourrait avoir contribué à une panne partielle de ce service en mai, sans que
la Fondation n’en attribue pour autant l’entière responsabilité à OpenAI.
Le coût caché de l’IA
Derrière cette affaire se joue une question beaucoup
plus large : combien coûte à l’Internet ouvert la multiplication des agents IA
?
Les robots traditionnels se contentent généralement de
parcourir et d’indexer les pages. Les agents autonomes peuvent, eux, analyser
une information, prendre une décision, appeler une API, interagir avec un
service et recommencer après un échec.
Cette autonomie change l’équation pour les plateformes
qui les accueillent.
Wikimedia rappelle qu’en 2025, sa consommation de
bande passante avait déjà augmenté de 50% sous l’effet de la hausse du trafic
des robots depuis 2024. Elle indiquait également que 65% du trafic consommant
le plus de ressources provenait de bots.
Le paradoxe est évident : l’Internet ouvert fournit
une partie de la matière première de l’intelligence artificielle, mais doit
désormais supporter le coût de systèmes d’IA capables d’y agir à grande
échelle.
Wikipédia au cœur de l’écosystème IA
Wikipédia compte aujourd’hui plus de 67 millions
d’articles dans plus de 300 langues et reçoit jusqu’à 15 milliards de
consultations par mois. Wikidata constitue, de son côté, une vaste base
structurée de connaissances utilisée par de nombreux services numériques.
Cette richesse en fait une ressource particulièrement
précieuse pour l’industrie de l’IA, mais aussi une infrastructure fortement
sollicitée.
Pour Wikimedia, le problème devient donc économique
autant que technique : serveurs, bande passante, sécurité et intervention
humaine ont tous un coût. Or la Fondation fonctionne comme une organisation à
but non lucratif.
L’affaire pose ainsi une question appelée à prendre de
l’ampleur : qui doit payer lorsque les agents IA consomment massivement les
infrastructures du web ?
Une nouvelle responsabilité pour les
entreprises d’IA
L’incident intervient alors qu’OpenAI fait face à une
problématique plus large autour du comportement imprévisible de certains
agents. L’entreprise a récemment alerté plus de 100 organisations au sujet
d’activités associées à des agents IA « rogue ».
Pour les plateformes, cela implique de renforcer
l’identification des agents, de limiter certaines requêtes et de sécuriser
davantage les API. Pour les entreprises d’IA, la question est celle de la
responsabilité lorsque leurs agents dépassent le cadre prévu par leurs
concepteurs.
L’affaire Wikimedia ne démontre donc pas que Wikipédia
aurait été « piraté » par OpenAI. Elle révèle un problème plus profond : l’Internet
qui a permis l’essor de l’intelligence artificielle doit désormais apprendre à
gérer les agents autonomes qu’elle fait naître.
La question n’est plus seulement de savoir ce que l’IA
peut faire. Il faudra aussi déterminer qui paie lorsque ses agents le font à
grande échelle.




Zinia Farnandiz Sep 28, 2024
Absolutely loved this post! Your tips on how to style a blazer are spot on. Keep up the great work, can’t wait for your next post!
Loren Watson Sep 18, 2024
Cover broad of topic in web development industry. Explained a lot of basic programming knowledge with easy to understand explanation.
Walter White Sep 29, 2024
Employees who have the flexibility to work remotely often report higher job satisfaction. This can lead to increased employee retention workforce.